XScrape: um "software" gratuito para extrair dados a partir do web
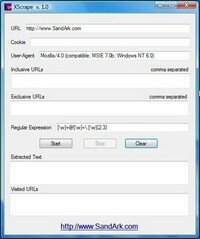
XScrape é um pequeno "software" gratuito que permite d’extrair cadeias de carácteres a partir do web. Ele percursos as páginas d’un relação à l’autre começando por um endereço de partida.
Se deseja recuperar emails, relações, as informações contidas méta-tags (como palavras chave) e todas as espécies d’autres dadas estratégicas, c’est por conseguinte o "software" qu’il é-vos necessário. Simples uma expressão regular far-lhe -á compreender o tipo de dado procurado.
Eis um tutoriel para ajudá-los à l’utiliser...
Instalação
Não d’installation, o "software" é portátil, como a maior parte de os que são apresentados sobre estes blog. Deverão mesmo assim assegurar-vos se que o framework. NÍTIDO é instalado bem sobre a vossa máquina. S’il n’est não instalado, fazem o download por aqui: Framework. NÍTIDO
Vista geral
L’interface do "software" é d’une simplicidade desconcertante, ele n’y a qu’un único ecrã, eis:
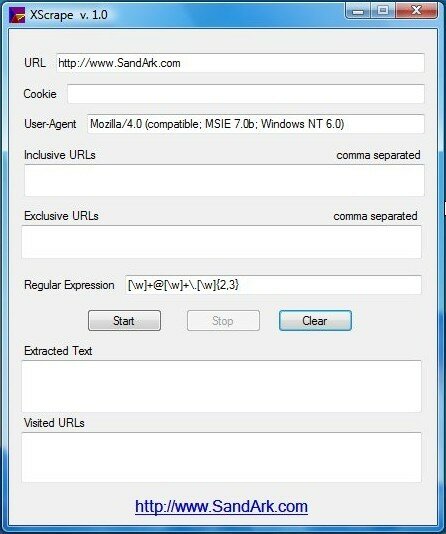
Vai dever informar pelo menos 2 zonas: l’adresse de partida (URL) e l’expression regular que corresponde aos dados procurados (Regular Expressão).
As expressões regulares
As expressões regulares - ou expressões racionais - permitem-vos encontrar num texto dado as cadeias de carácteres que obedecem a um esquema específico. A sua sintaxe é detalhada sobre esta página de referência: regular-expressions.info.
Eis dois exemplos para começar:
- Um endereço correio electrónico: [ \w]+@[\w]+\.[\w]{2,3}
- Uma relação: < a[^]*href=”http[^]*>[^]*</a >
Os endereços a incluírem
No campo Inclusivos URLs, vai apreender a lista dos endereços web que XScrape pode atravessar. Cada relação deve ser separada por uma vírgula. As relações encontradas que não contêm l’une destes endereços não serão consultadas.
Por exemplo se ponho wikipedia.org, XScrape poderá visitar en.wikipedia.org ou fr.wikipedia.org/wiki/ mas não wikimedia.fr
Os endereços a excluírem
No campo Exclusivos URLs, vai apreender a lista dos endereços web que não deverão ser atravessados por XScrape. Por exemplo pode-se ter wikipedia.org nos endereços a incluir e en.wikipedia.org nos endereços a excluírem. Cada relação da lista deve ser separada por uma vírgula.
O cookie
Se l’adresse de partida n’est acessível que por palavra de passagem, será necessário utilizar um Cookie. Para recuperar as informações de cookie, saissez simplesmente “javascript:document.write(document.cookie);” no campo dirige do vosso navegador. Seguidamente, feitos em um copiar colado no campo cookie de XScrape.
A seguir...
No próximo artigo, mostrá-los-ei como utilizar XScrape para escolher uma lista de blogs de acordo com o seu índice de popularidade (na acepção de Technorati).
Tags: aplicação portátil , datou extractor , expressão regular , expressões racionais , gratuito , grep , parser , parseur , pattern , regular expressão , tutoriel
Se gostar de este artigo, der mais visibilidade votando por ele sobre Scoopeo:
Artigos similares (em teoria):
Como escolher uma lista de blogs de acordo com o seu índice de popularidade Technorati?
Encontrar d’un facilmente l’équivalent gratuito "software" comercial
Alojamento gratuito durante 1 ano em 1&1!
Como extrair os ficheiros contidos num ficheiro d’installation?
Um "software" gratuito e eficaz para criar diagramas


Um "software" gratuito para extrair dados estratégicos a partir do web said,
Wrote ele Março 7,.2008 @ 20:01
[ … ] Um "software" gratuito para extrair dados estratégicos a partir do webceclair.fr/applications-portables/xscrape-un-logiciel-gratui… por argancel há alguns segundos [ … ]
www.blogmemes.fr said,
Wrote ele Março 7,.2008 @ 20:06
Um "software" gratuito para extrair dados estratégicos a partir do web…
- Gosta de este artigo? Votam por sobre Blogmemes.fr!XScrape é-lhe um pequeno "software" gratuito que permite d’extraire todas as espécies d’informations a partir do web: emails, relações, informações contidas em méta tags, e muito d’autres…
Nabil said,
Wrote ele Março 7,.2008 @ 20:31
Obrigado para l’info.
Como escolher uma lista de blogs de acordo com o seu índice de popularidade Technorati? said,
Wrote ele Março 10,.2008 @ 19:48
[ … ] o precedente artigo, aprendemos a servir-nos do "software" gratuito XScrape, que permite d’extraire [ de … ]