Как сортировать перечень blogs согласно их индексу славолюбия Technorati?
В предшествующая статья, мы выучили как служить к нам как свободно средство программирования XScrape, который делает его по возможности извлечь от данных стержня. Мы будем использовать его сегодня в практически примере: сортировать перечня blogs согласно их индексу Technorati.
Индекс славолюбия blog, в пределах смысли Technorati, соответствует к числу blogs по-разному которое связывает к этому blog. Не будет неизбежно индикацией качества а индикатора blog влияния в blogosphère, которое можно также отнести к емкостям автора повысить его blog. Таким образом логически быть заинтересованным в ем изучить методы blogueurs преуспели в делать их отверстие.
Посоветовать с индексом Technorati blog, что-нибыдь более просто: оно достаточно для того чтобы посоветовать с страницой http://www.technorati.com/blogs/ {adresse_du_blog_voulu}. Следовательно, кажется легко автоматизировать спасение индекса Technorati нескольких спасибо blogs XScrape.
Для того чтобы сделать нашу компанию интересуя, мы положимся дальше blogs списка личного развития крумциркуля микрометра Присцилла (eh да, I не истомлено любые;). Сортировать перечня Присцилла будет продолжать в 4 определенных участках:
- Автоматическое спасение скреплений blogs страницы крумциркуля микрометра Присцилла
- Преобразование этих скрепляет в скрепления Technorati
- Автоматическое спасение индексов Technorati всех blogs
- Полученный сортировать информации
Автоматическое спасение скреплений blogs страницы крумциркуля микрометра Присцилла
Для того чтобы взять скрепления перечня blogs крумциркуль микрометра Присцилла, оно достаточно для того чтобы унести XScrape с following параметрами:
URL : http://priscillapalmer.com/pdl.php/
Включительное URLs : http://priscillapalmer.com/pdl.php/
Исключительное URLs : http://priscillapalmer.com/,http://www.priscillapalmer.com/
Регулярно выражение : <HTTP *href= [<> ^]» [^]<> имеет *target=» _blank» [^<>] *> [^<>] *< /a>
Быстро анализирует страницу моделей Присцилла деиствительно оно по возможности для того чтобы увидеть что все скрепления listed blogs имеют target=» _blank» атрибута, которое делает его по возможности взять хорошие скрепления автоматически.
Преобразование этих скрепляет в скрепления Technorati
Поже берущ результат XScrape в текстуальном архиве, просто деятельность замены достаточно для того чтобы получить скрепления Technorati:
- Заменить http:// : http://www.technorati.com/blogs/
На момент, я не нашел середины но анализировать HTML страницы без использования HTTP адреса. Iий таким образом одевает в эту страницу мой местный кельнер TAK, CTO XScrape сможет найти архив. То дает адрес вида http://localhost/…
Автоматическое спасение индексов Technorati всех blogs
Pour récupérer les indices de technorati des blogs de la liste de Priscilla Palmer, il suffit d’exécuter XScrape avec les paramètres suivants :
URL : http://localhost/lienstechnorati.html (la page qu’on a construit à l’étape précédente)
Inclusive URLs : http://www.technorati.com/blogs/
Exclusive URLs : http://www.technorati.com/blogs/tag/
Regular Expression : <a[^<>]*class=”links”[^<>]*href=”/search/[^<>]*title=”View[^<>]*blog[^<>]*reactions”>Authority: [^<>]*</a>[^<>]*</div>[^<>]*<div>[^<>]*<a[^<>]*class=”fav
Pour trouver la bonne expression régulière, il faut consulter le code source d’une page de blog Technorati. Ensuite en tatônnant un peu, on obtient finalement la bonne expression régulière.
Notons que cette méthode m’a permi de récupérer environ 80% des indices technorati, et ceci pour 3 raisons :
1/Certains liens ne correspondaient pas à la racine du blog
2/Certains liens n’ont pas encore d’indice car personne n’a encore lié à leur blog
3/Certains liens ne sont pas des blogs
Triage des informations obtenues
Avec un peu d’excel et un peu d’autohotkey, on peut faire des merveilles.
Voici comment j’ai procédé :
- J’ai d’abord supprimé dans la sortie obtenue toutes les données inutiles
- Puis j’ai transformé le fichier en format CSV par des remplacements successifs pour obtenir des lignes où les colonnes sont séparées par des points virgule, pour pouvoir l’importer dans Excel :
http://www.threesixtyalliance.com/360-view;6
http://www.todayisthatday.com/blog;314
http://www.positiveselftalkguide.com;46
etc.
- Pour connaître les blogs dont on n’a pas pu avoir l’indice, il est intéressant aussi d’importer les données de la liste obtenue lors de l’étape 1 dans le même fichier excel afin de faire une comparaison.
- Grâce à un script autohotkey, on peut ensuite facilement faire correspondre les colonnes et obtenir un résultat de ce genre :
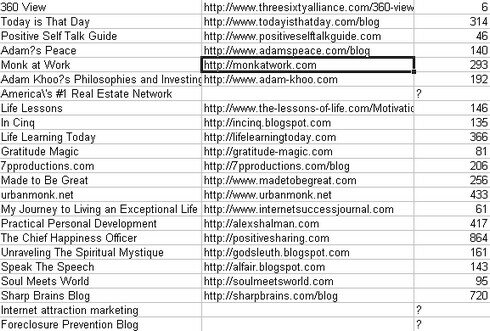
(il y a en tout 727 lignes)
- On peut ensuite trier les lignes et exporter toutes ces données dans un fichier HTML pour obtenir la liste finale.
Conclusion
J’espère que grâce à cet article, vous aurez pu découvrir la puissance de XScrape. On remarquera qu’il est possible de faire la même chose en utilisant l’API de Technorati, mais la méthode présentée ici a l’avantage de ne nécessiter aucune connaissance en programmation.
Dans le prochain article, vous trouverez la liste complète des blogs de développement personnel de Priscilla Palmer triés selon leur indice Technorati.
Tags: autohotkey, blog, Développement Personnel, Excel, expression régulière, liste, parseur, popularité, regular expression, technorati, tutoriel, xscrape
Articles similaires (en théorie) :
Il y a un an sur C’éclair! - mars 2008
Stats
XScrape : un logiciel gratuit pour extraire des données à partir du web
Page de stats : où trouver les meilleurs scripts de statistiques
Il y a un an sur C’éclair! - février 2008




Jean Michel said,
Wrote on mars 10, 2008 @ 20:05
Un tuto bien expliqué beau travail
Bonne fin de journée:)
Wojciech said,
Wrote on mars 28, 2009 @ 0:56
Hello admin. Very good web site, great work and thank you for your service. for Youre a genius! spring, Thank you for your site